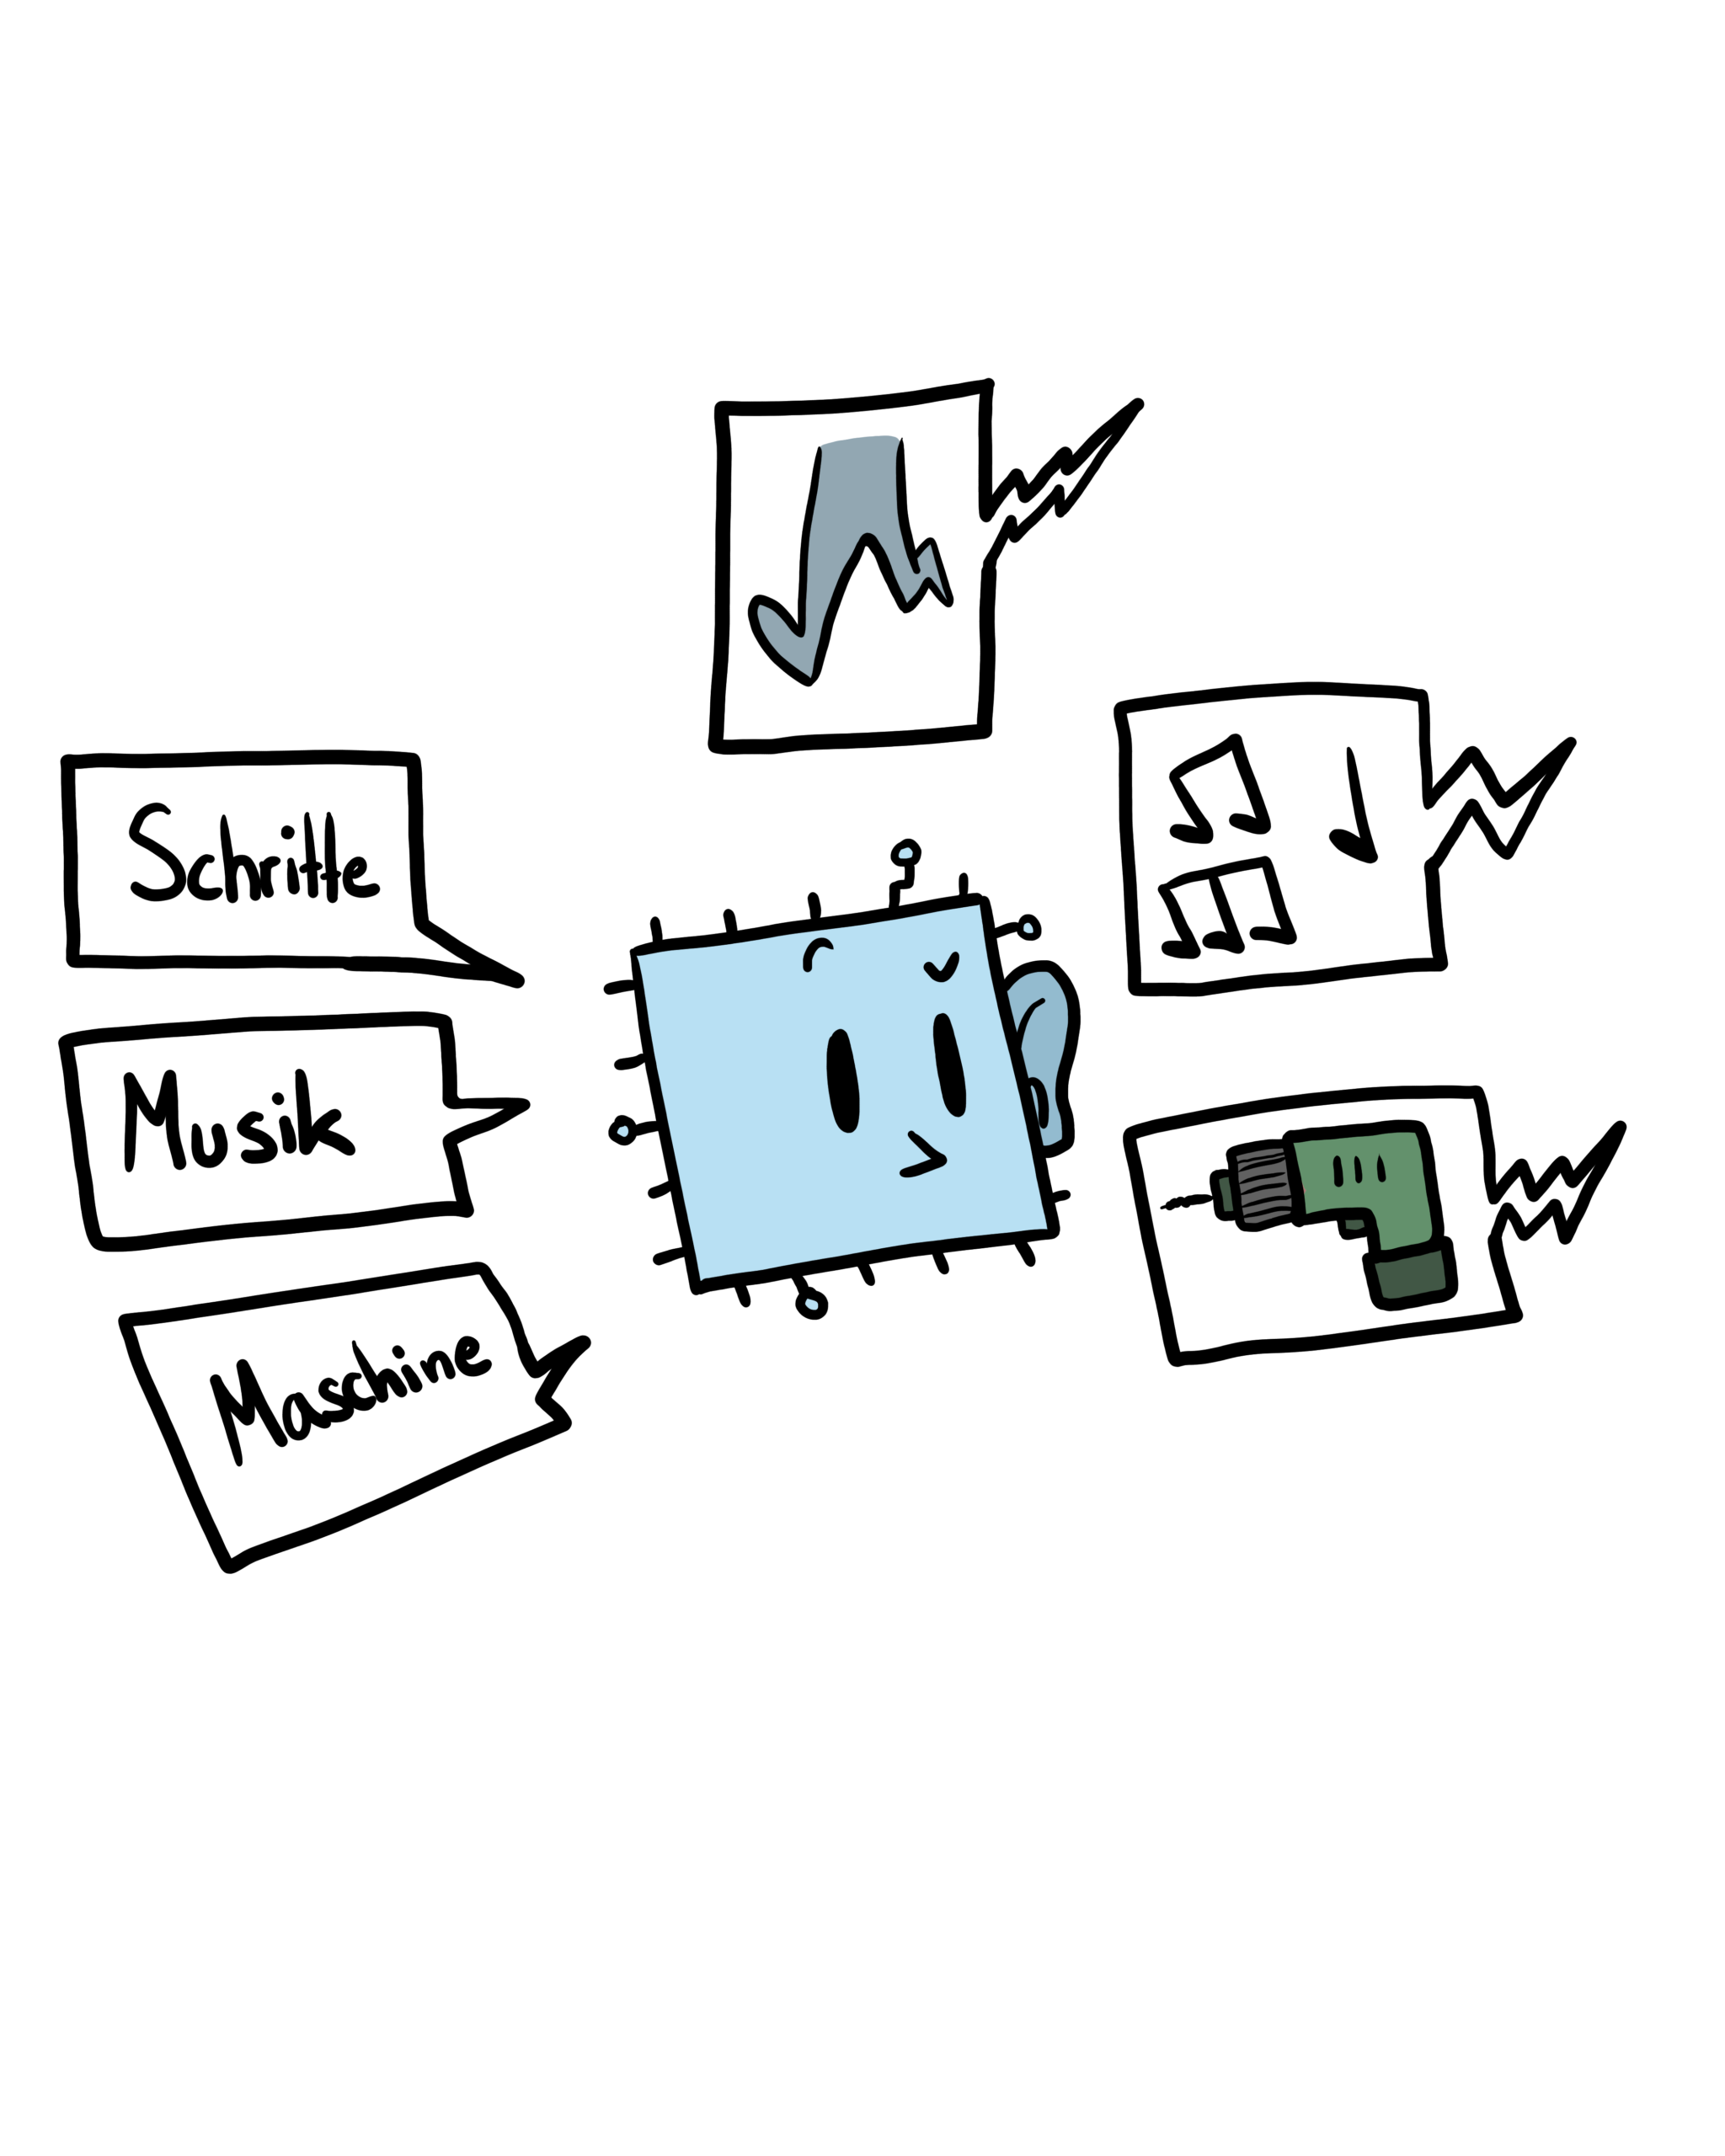
Stellen wir uns vor: Eine KI „hört“ einen Ton – zum Beispiel das Klirren von Glas, das Piepen eines Rauchmelders oder das Rattern einer defekten Pumpe. Sie erkennt, was dieser Ton bedeutet, weil sie zuvor mit vielen ähnlichen Beispielen „trainiert“ wurde.
Dabei analysiert die KI nicht den Ton wie ein Mensch mit dem Ohr, sondern in Form von Wellen und Frequenzen. Vereinfacht gesagt: Sie „sieht“ das Geräusch als Bild und erkennt darin typische Formen. Dabei geht es nicht nur darum, Sprache zu erkennen, wie bei der Spracherkennung, sondern um das Erkennen, welche Art von Geräuschen vorliegt.
Die Grundlage ist das maschinelle Lernen, mit dieser Methode trainiert das KI-System sich grundsätzlich selbst. Dafür ist jedoch vor dem ersten Einsatz Audiomaterial zum Training nötig. Dabei wird gelernt, wie bestimmte Klänge aufgebaut sind, um wen oder was es sich dabei handelt, und lernt diese voneinander zu unterscheiden. In der Folge lernt das System durch unsere Verwendung und die jeweilige Rückmeldung an das System. So weiß die KI, welche Art von Geräusch sie hört, jedoch nicht, wer spricht oder welches konkrete Objekt den Ton erzeugt.
Beispiele zu den Möglichkeiten:
- Erhöhung der Sicherheit: Warnsignale oder Gefahrensituationen können erkannt werden, bevor sie für den Menschen sichtbar oder hörbar werden, so können Schäden oder Ausfälle vermieden werden.
- Mehr Komfort: Störgeräusche oder unangenehme Umgebungsbedingungen können mit der entsprechenden KI-Ausstattung herausgefiltert oder reduziert werden.
- Schnelle Fehlersuche: durch die KI-Geräuscherkennung können ungewöhnliche Geräusche zum Beispiel an Maschinen erkannt werden.
- Materialerkennung: ob Holz, PVC oder Metall – die Klanganalyse sagt es uns.
Abgrenzung zu anderen KI-Fähigkeiten – Kurz und knapp
01 | Audios erstellen = Neues erschaffen
02 | Audios verändern = Altes bearbeiten
03 | Audios erkennen = verstehen
04 | Audios identifizieren = eindeutig zuordnen
Der feine Unterschied der Karten 03 und 04:
Audios erkennen ist also die Grundlage für Audios identifizieren. Beim Erkennen wird unterschieden zwischen den Quellen, wie Sprache, Vogelgezwitscher, Motorengeräusch etc. Wenn Audios identifiziert werden, erfolgt eine spezifische Zuordnung. Hierbei kann zum Beispiel zwischen den verschiedenen sprechenden Personen unterschieden werden und wenn diese Sprachmuster bekannt und zugeordnet wurden, können die Personen auch benannt werden.